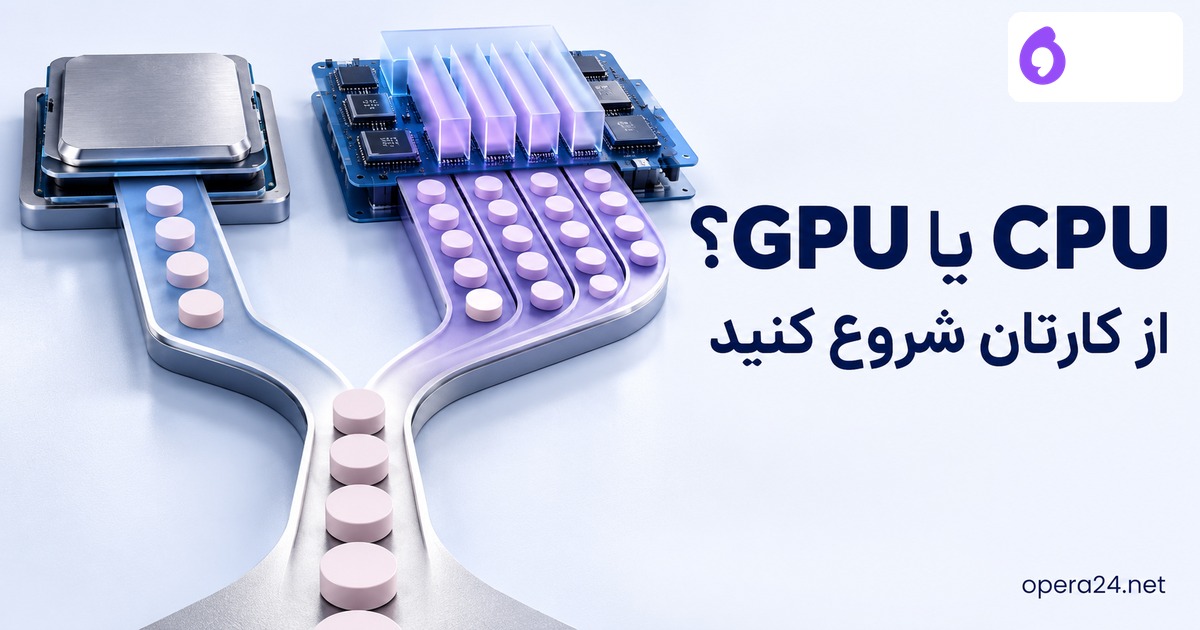
انتخاب CPU یا GPU را با اندازه مدل، زمان قابل قبول و تعداد درخواستها انجام دهید. برای آزمایش محدود، CPU میتواند نقطه شروع باشد اگر موتور و مدل آن را پشتیبانی کنند. GPU نیز فقط وقتی مفید است که مسیر اجرا واقعاً از آن استفاده کند.
هوش مصنوعی بدون کارت گرافیک یعنی چه؟
این پرسش میتواند دو منظور داشته باشد: استفاده از سرویس آماده بدون پردازش محلی، یا اجرای مدل روی CPU دستگاه خودتان. این دو را جدا کنید. در حالت اول باید شرایط سرویس و خروجی را بررسی کنید؛ در حالت دوم، سازگاری نرمافزار، حافظه، مدل و زمان اجرای قابل قبول اهمیت پیدا میکند.
پاسخ را با نام CPU یا GPU تمام نکنید. برای مثال، اگر خروجی باید در حین یک تعامل آماده شود، محدودیت زمانی با یک پردازش دستهای فرق دارد. اگر داده نباید از دستگاه خارج شود، مسیر واقعی شبکه و ذخیرهسازی هم مهم است. از عبارت «محلی» نتیجه آفلاینبودن همه اجزای نرمافزار را نگیرید.
پیش از مقایسه، شرایط را ثابت نگه دارید
| شرط | ثبت پیشنهادی |
|---|---|
| مدل | نام، نسخه، قالب و تنظیمات یکسان |
| ورودی | چند نمونه مشابه کار واقعی، با اندازه مشخص |
| کیفیت | معیار پذیرش مشترک برای هر دو اجرا |
| زمان | شروع، اولین خروجی و پایان با تعریف ثابت |
| دستگاه | حافظه، نرمافزار و پردازشهای همزمان ثبت شوند |
اگر مدل یا اندازه ورودی بین دو حالت عوض شود، تفاوت زمان را فقط به نوع پردازنده نسبت ندهید. همچنین نتیجه را همراه کیفیت خروجی بخوانید؛ تولید سریعتر پاسخ نامناسب برای کار شما مزیت عملی را ثابت نمیکند. این روش پیشنهادی آزمون است و نتیجه اندازهگیری روی دستگاه خاصی در این مقاله ارائه نشده است.
برای مدل بزرگ، تقسیم کار یا بارگذاری بخشها میتواند به ابزار و روش اجرا وابسته باشد. راهنمای رسمی Big Model Inference را برای درک همین محدودیتها بخوانید؛ وجود چنین روشی تضمین زمان یا کیفیت در دستگاه شما نیست. اگر به انتخاب GPU رسیدید، راهنمای کارت گرافیک برای هوش مصنوعی مسیر بعد است.
اگر مسئله شما هنوز در حد انتخاب کاربرد است، از راهنمای عمومی هوش مصنوعی شروع کنید. خرید سختافزار را با نیاز به یک ابزار آماده یا سرویس راهاندازی تیمی یکسان نگیرید؛ ابتدا نتیجهای را که میخواهید تحویل بگیرید مشخص کنید.
ابتدا حد قابل قبول را بنویسید
یک کار شبانه که خروجی آن صبح لازم است، با چت تعاملی یکسان نیست. برای کار نخست، زمان پایان کل مهمتر است؛ برای چت، شروع پاسخ و فاصله بین بخشهای پاسخ هم اهمیت دارد. کیفیت پاسخ را در هر دو محیط با ورودی برابر بسنجید. تغییر همزمان مدل و دستگاه، علت تفاوت را مبهم میکند.
اجرای آزمایشی کمهزینه
مدل و تنظیمات را ثابت نگه دارید، یک متن کوتاه و یک متن بلند آماده کنید و زمان بارگذاری را از تولید جدا ثبت کنید. وضعیت پردازش و مصرف حافظه را از ابزار رسمی موتور بخوانید. اگر GPU شناسایی نشده، پیش از نتیجهگیری درباره سرعت کارت، سازگاری و درایور را بررسی کنید. از خرید برای رفع خطایی که هنوز تشخیص داده نشده پرهیز کنید.
نمونه عملی
فرض کنید پنج گزارش در پایان روز خلاصه میشوند. اگر اجرای CPU در زمان مجاز تمام شود و کیفیت کافی باشد، GPU الزام این کار نیست. اما وقتی کاربر پشت صفحه منتظر پاسخ است، همان زمان ممکن است نامناسب باشد. در کاربرگ برای هر وظیفه یک حد انتظار و یک شاهد کیفیت تعریف کنید. سپس خروجی واقعی را وارد کنید؛ این مثال نمیگوید CPU همیشه ارزانتر یا GPU همیشه سریعتر خواهد بود.
| مورد بررسی | کار یا شاهد لازم | نتیجه مورد انتظار |
|---|---|---|
| نوع کار | تعاملی یا پردازش دستهای را مشخص کنید | معیار زمان درست |
| محیط ثابت | مدل و تنظیمات یکسان باشند | مقایسه قابل تفسیر |
| پایش دستگاه | استفاده واقعی از CPU یا GPU را بخوانید | مسیر اجرا تأیید شود |
| پذیرش | کیفیت و زمان با هم بررسی شوند | تصمیم متناسب وظیفه |
کاربرگ قابل استفاده
ردیفهای جدول در فایل CSV این راهنما قرار دارند. ستون نتیجه واقعی، مسئول و تاریخ را پس از بررسی خودتان تکمیل کنید. مثالهای این نوشته آموزشیاند و گزارش آزمون یک محصول یا مشتری نیستند.
محدودیت و قدم بعد
مقایسه روی یک ورودی کوچک، نتیجه همه کارها نیست. هزینه برق، نگهداری و دسترسی به دستگاه نیز باید با شرایط واقعی سنجیده شوند؛ این متن تعرفه یا بنچمارک ارائه نمیکند.
اگر مسئله اصلی شما پاسخگویی به مشتری است، پیش از هزینه برای زیرساخت، یک گفتوگوی واقعی و معیار پذیرش آن را مشخص کنید. برای آشنایی با مسیر محصول، راهنمای چت سایت اپرا و دموی اپرا را ببینید. این راهنما به معنی ارائه خدمات خرید یا اجرای GPU محلی از طرف اپرا نیست.